무료 뉴스 API로 자동 수집기를 만들 때 가장 위험한 코드는 실패 즉시 다시 호출하는 재시도입니다. 상대 서버가 요청을 줄이라고 말하는데 프로그램이 더 빠르게 호출하면 일시적인 제한을 스스로 연장할 수 있습니다.
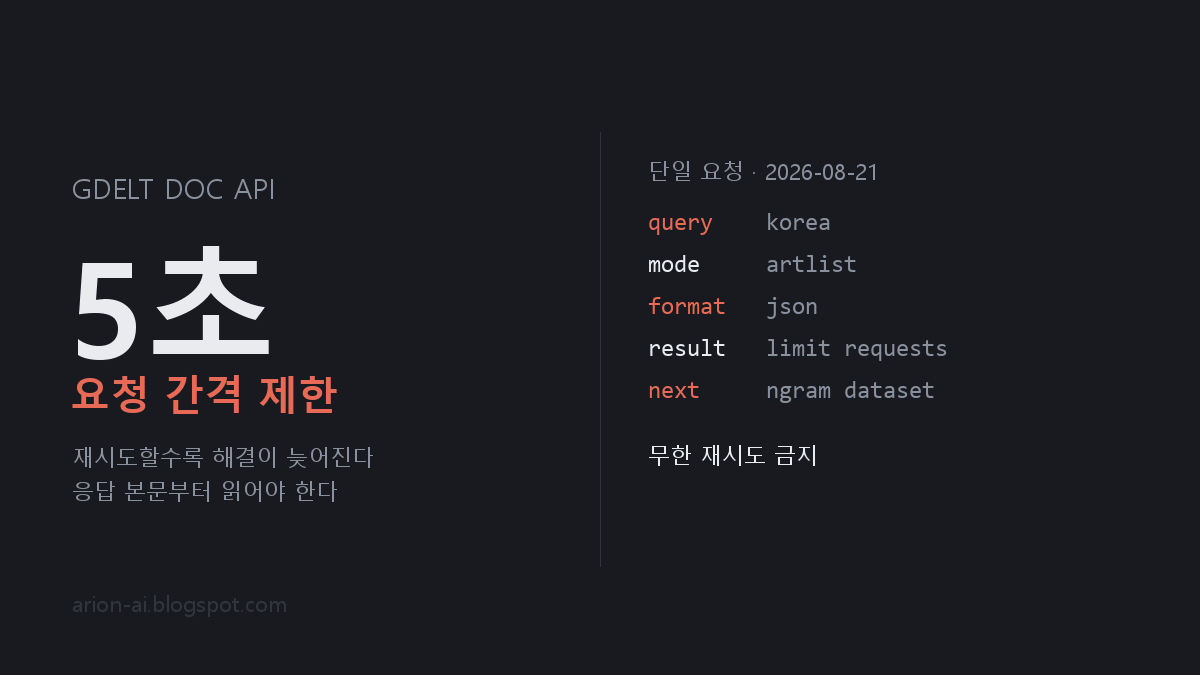
2026년 8월 21일 GDELT DOC 2.0 API에 기사 목록 요청을 한 번 보냈습니다. 기대한 JSON 대신 요청을 최소 5초에 한 번으로 제한하라는 안내문이 돌아왔습니다. 고빈도 사용자는 Web NGrams 데이터셋을 이용하라는 대안도 함께 표시됐습니다.
3줄 결론
- 응답 확장자가 JSON이어도 본문이 항상 JSON이라는 보장은 없습니다
- 제한 안내를 받으면 즉시 재시도하지 말고 최소 간격과 상한을 둡니다
- 대량 분석은 검색 API 반복 호출보다 제공자가 권하는 데이터셋이 적합합니다
확인일 2026-08-21 · 대상: GDELT DOC 2.0 API 단일 요청 1회
가장 작은 요청부터 시작하기
GDELT DOC 2.0 API는 뉴스 기사를 검색하고 목록이나 타임라인 형태로 결과를 받을 수 있는 공개 인터페이스입니다. 수집기를 만들기 전에 브라우저나 curl로 작은 요청 하나를 보내 응답 형식을 확인하는 것이 좋습니다.
이번에 사용한 요청은 검색어 korea, 기사 목록 모드, 최대 3건, JSON 형식이었습니다.
curl --max-time 25 \
  "https://api.gdeltproject.org/api/v2/doc/doc?query=korea&mode=artlist&maxrecords=3&format=json"
maxrecords=3으로 시작한 이유는 처음부터 수백 건을 가져오는 코드를 작성하지 않기 위해서입니다. 연결, 제한, 응답 구조를 작은 비용으로 먼저 확인할 수 있습니다.
JSON 대신 안내문이 돌아온 이유
실행 당시 기사 배열이 아니라 다음 취지의 평문이 반환됐습니다.
Please limit requests to one every 5 seconds.
High-traffic users should switch to the ngrams dataset.
여기서 중요한 점은 클라이언트가 format=json을 요청했다는 사실만 믿으면 안 된다는 것입니다. 제한이나 오류 상황에서는 정상 스키마가 아닌 텍스트나 HTML이 돌아올 수 있습니다. 곧바로 JSON 파서를 실행하면 원래 원인 대신 JSONDecodeError만 기록됩니다.
따라서 파싱 전에 HTTP 상태, Content-Type, 본문 앞부분을 확인하고 예상 스키마인지 검증해야 합니다. 이번 증거에는 응답 본문만 보존되어 있어 HTTP 상태 코드는 확인하지 못했습니다. 상태 코드까지 200이었다고 단정하지 않는 이유입니다.
무한 재시도를 막는 구조
실패하면 바로 다시 호출하는 코드는 제한 상황에서 가장 나쁜 동작입니다. 최소한 다음 네 가지를 둡니다.
- 요청 사이의 최소 간격
- 지수 백오프
- 전체 재시도 횟수 상한
- 마지막 실패 원문 보존
예를 들어 첫 실패 뒤 5초, 다음은 10초, 그 다음은 20초를 기다리고 세 번에서 멈출 수 있습니다. 서버가 Retry-After 헤더를 제공한다면 임의 숫자보다 그 값을 우선합니다. 무작위 지연을 조금 섞으면 여러 작업이 동시에 다시 몰리는 현상도 줄일 수 있습니다.
const delays = [5000, 10000, 20000];

for (const delay of delays) {
  const result = await requestOnce();
  if (result.ok) return result;
  await wait(delay);
}
throw new Error("GDELT 요청 재시도 상한 도달");
이 코드는 개념 예시입니다. 실제 제한 조건은 서비스의 현재 안내와 응답을 다시 확인해야 합니다.
검색 API와 데이터셋을 구분한다
몇 개의 최신 기사나 특정 사건을 확인하려면 검색 API가 편합니다. 하지만 긴 기간의 추세를 만들거나 많은 검색어를 반복해서 조사한다면 API를 연속 호출하는 구조가 맞지 않을 수 있습니다.
이번 제한 안내는 고빈도 사용자에게 Web NGrams 데이터셋을 권했습니다. GDELT는 별도의 데이터 다운로드 경로도 제공합니다. 대량 분석을 계획한다면 제공자가 준비한 데이터셋을 내려받아 로컬에서 필터링하는 편이 요청 제한과 재현성 측면에서 유리합니다.
“무료 API”는 호출 비용이 0원이라는 뜻일 뿐, 무제한 사용이나 항상 같은 응답 형식을 보장한다는 뜻은 아닙니다.
자동 콘텐츠 수집에서 지켜야 할 선
뉴스 API 결과를 그대로 이어 붙여 블로그 글을 대량 생성하면 독자에게 새로운 가치가 없습니다. Google 검색 정책도 여러 출처를 조합하거나 AI로 많은 페이지를 만들면서 가치를 추가하지 않는 행위를 경계합니다.
뉴스 데이터는 소재 발견과 사실 확인의 출발점으로만 사용하고, 원문 출처 확인, 날짜 검증, 직접 분석, 사람 승인을 거쳐야 합니다. API 응답에 기사가 나타났다는 사실과 그 기사의 주장이 정확하다는 사실도 구분해야 합니다.
자주 묻는 질문 FAQ
Q. GDELT API는 무료인가요?
공개 데이터와 API를 제공하지만 요청 제한과 권장 사용 방식이 있습니다. 대량 사용 전에 공식 안내를 확인해야 합니다.
Q. 5초마다 호출하면 항상 성공하나요?
보장되지 않습니다. 당시 응답에서 확인한 최소 안내일 뿐이며 네트워크 상태, 서비스 부하, 사용 패턴에 따라 달라질 수 있습니다.
Q. 응답이 JSON이 아니면 어떻게 하나요?
파싱을 멈추고 상태 코드, Content-Type, 본문 일부를 기록합니다. 제한 안내인지 서버 오류인지 먼저 구분합니다.
Q. 기사를 자동으로 블로그에 발행해도 되나요?
원문 복제, 저작권, 출처, 정확성, 저가치 대량 콘텐츠 문제가 생길 수 있습니다. 자동 수집 결과는 발행 후보 자료로만 다루는 것이 안전합니다.
실행 체크리스트
- 처음에는 결과 3건 정도의 작은 요청을 보낸다
- 상태 코드와 Content-Type을 파싱 전에 검사한다
- 정상 JSON 스키마인지 확인한다
- 최소 요청 간격과 지수 백오프를 둔다
- 재시도 횟수 상한을 둔다
- 실패 응답 원문을 보존한다
- 대량 분석은 공식 데이터셋 사용을 검토한다
- 수집 결과를 사람 검수 없이 자동 발행하지 않는다
참고 자료
출처 확인일: 2026-08-21


댓글